Hoe ik 2.000 productpagina's met AI herschrijf zonder copywriter-tarief
- ai
- e-commerce
- content
- pipeline
Voor een eigen webshop die ik bouw heb ik een catalogus van rond de 2.000 producten. Auto-detailingproducten, drie talen, technisch genoeg dat goedkope copywriting opvalt en duur genoeg dat handmatige copy een paar maanden zou kosten. Geen redelijke kosten-baten als ik elke productpagina zelf zou tikken.
Tegelijk heb ik een hekel aan de generatieve productpagina's die je nu overal ziet: "ervaar de premium kwaliteit van...". Geen feiten, geen specs, geen reden om te kopen. Pure AI-vulling. Google straft het, klanten ruiken het.
Wat ik in plaats daarvan heb gebouwd is een pipeline met drie LLM-rollen, elk met een eigen verantwoordelijkheid. Hieronder leg ik uit hoe die in elkaar zit, wat de output is, en waarom dit niet hetzelfde is als "wij genereren productteksten met ChatGPT".
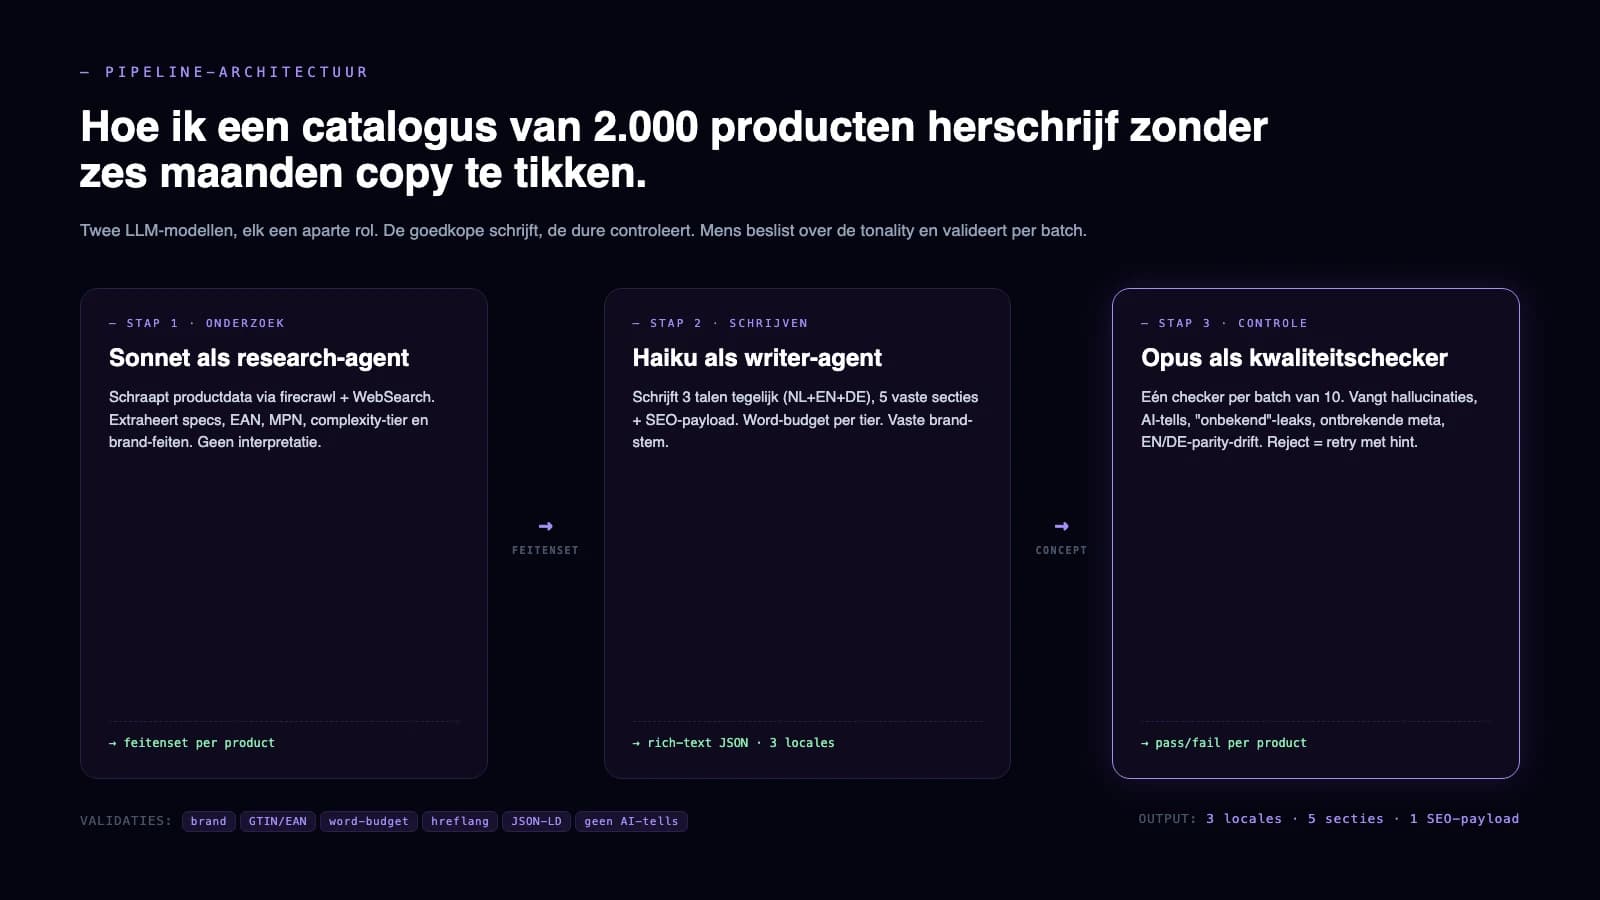
De architectuur in drie stappen
Stap 1: Sonnet als onderzoeker. Per product haal ik de productdata op via firecrawl en gerichte web-search. De agent extraheert specs (volume, pH-waarde, geur, samenstelling, geschikt voor), identifiers (EAN, MPN, GTIN, merk), categorie en complexity-tier. Geen interpretatie, geen schrijfwerk. Alleen feiten in een gestructureerd JSON-document.
Dit deel is het belangrijkste, ook al lijkt het saai. Als de feitenset niet klopt schrijft de volgende stap nonsens. Daarom draait er een hard sanity-check: ontbreekt de EAN, dan stopt de pipeline en wordt het product naar een handmatige queue gestuurd. Geen rommel doorlaten.
Stap 2: Haiku als schrijver. Een goedkope, snelle agent die per product 3 talen tegelijk schrijft: Nederlands, Engels en Duits. Vijf vaste secties per locale:
- Korte omschrijving (60-120 woorden, beschrijft wat het product is)
- Wat zit erin (literal: aantal flessen, formaat, accessoires)
- Waarom dit product (bullet-list met 4-6 inhoudelijke argumenten)
- Hoe je het gebruikt (genummerde stappen)
- Plus- en minpunten (eerlijk, dus inclusief minpunten)
Plus een SEO-payload: meta-titel (max 60 tekens, met merk en productnaam), meta-description (max 155 tekens), tags, en een veld voor JSON-LD-data. Word-budget per tier. Vaste brand-stem die per project geconfigureerd is in een prompt-template.
Stap 3: Opus als kwaliteitschecker. Per batch van tien producten draait er één Opus-agent als reviewer. Die checkt:
- Geen "onbekend"-leaks in de output (een klassieke AI-tell: "geschikt voor onbekend")
- Geen gehallucineerde termen ("conform de EU-richtlijn voor X" als X niet bestaat)
- EN/DE-parity met de Nederlandse versie (zelfde kernfeiten, niet dezelfde woordkeuze)
- Word-budget gerespecteerd, AI-tells absent ("delve", "robuust", "naadloos")
- SEO-payload compleet en correct (lengte, format, JSON-LD-vereisten)
Failt iets, dan retry de Haiku-stap met een specifieke hint. Slaagt het, dan gaat het naar de import-tabel met een quality_passed vlag.
Hoe de output er in de praktijk uit ziet
Een voorbeeld uit de pilot: D-CON Mint Splash Shampoo. Dit is de Nederlandse PDP die uit de pipeline rolt:
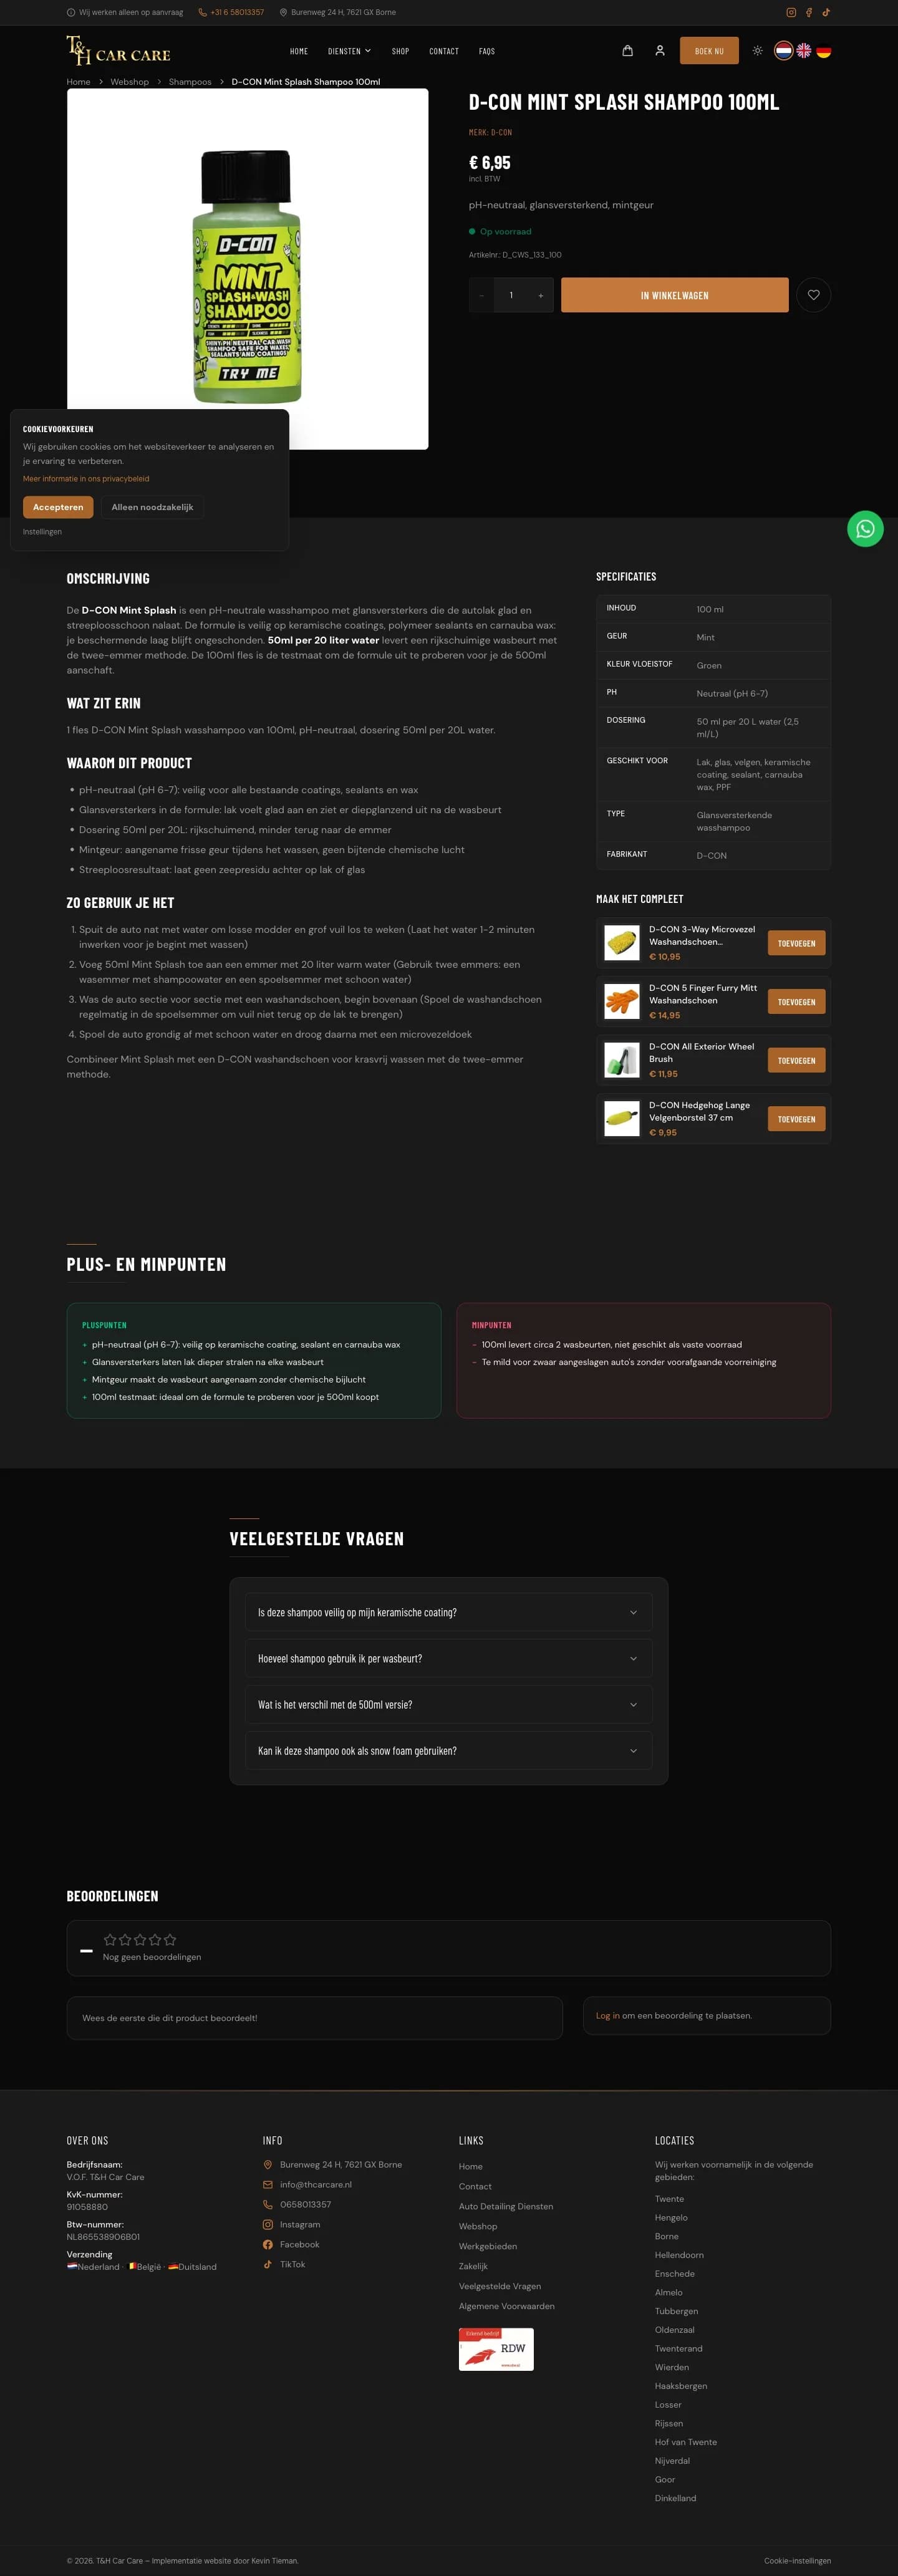
Specs links, lopende tekst rechts. Plus- en minpunten in een eerlijke twee-koloms-box. FAQ onderaan met antwoorden die uit de feitenset komen, niet uit de Haiku-fantasie. Inclusief de minpunten (100ml levert circa 2 wasbeurten, niet geschikt als vaste voorraad) omdat eerlijkheid converteert.
En dezelfde productpagina in het Engels, vanuit dezelfde pipeline-doorloop:
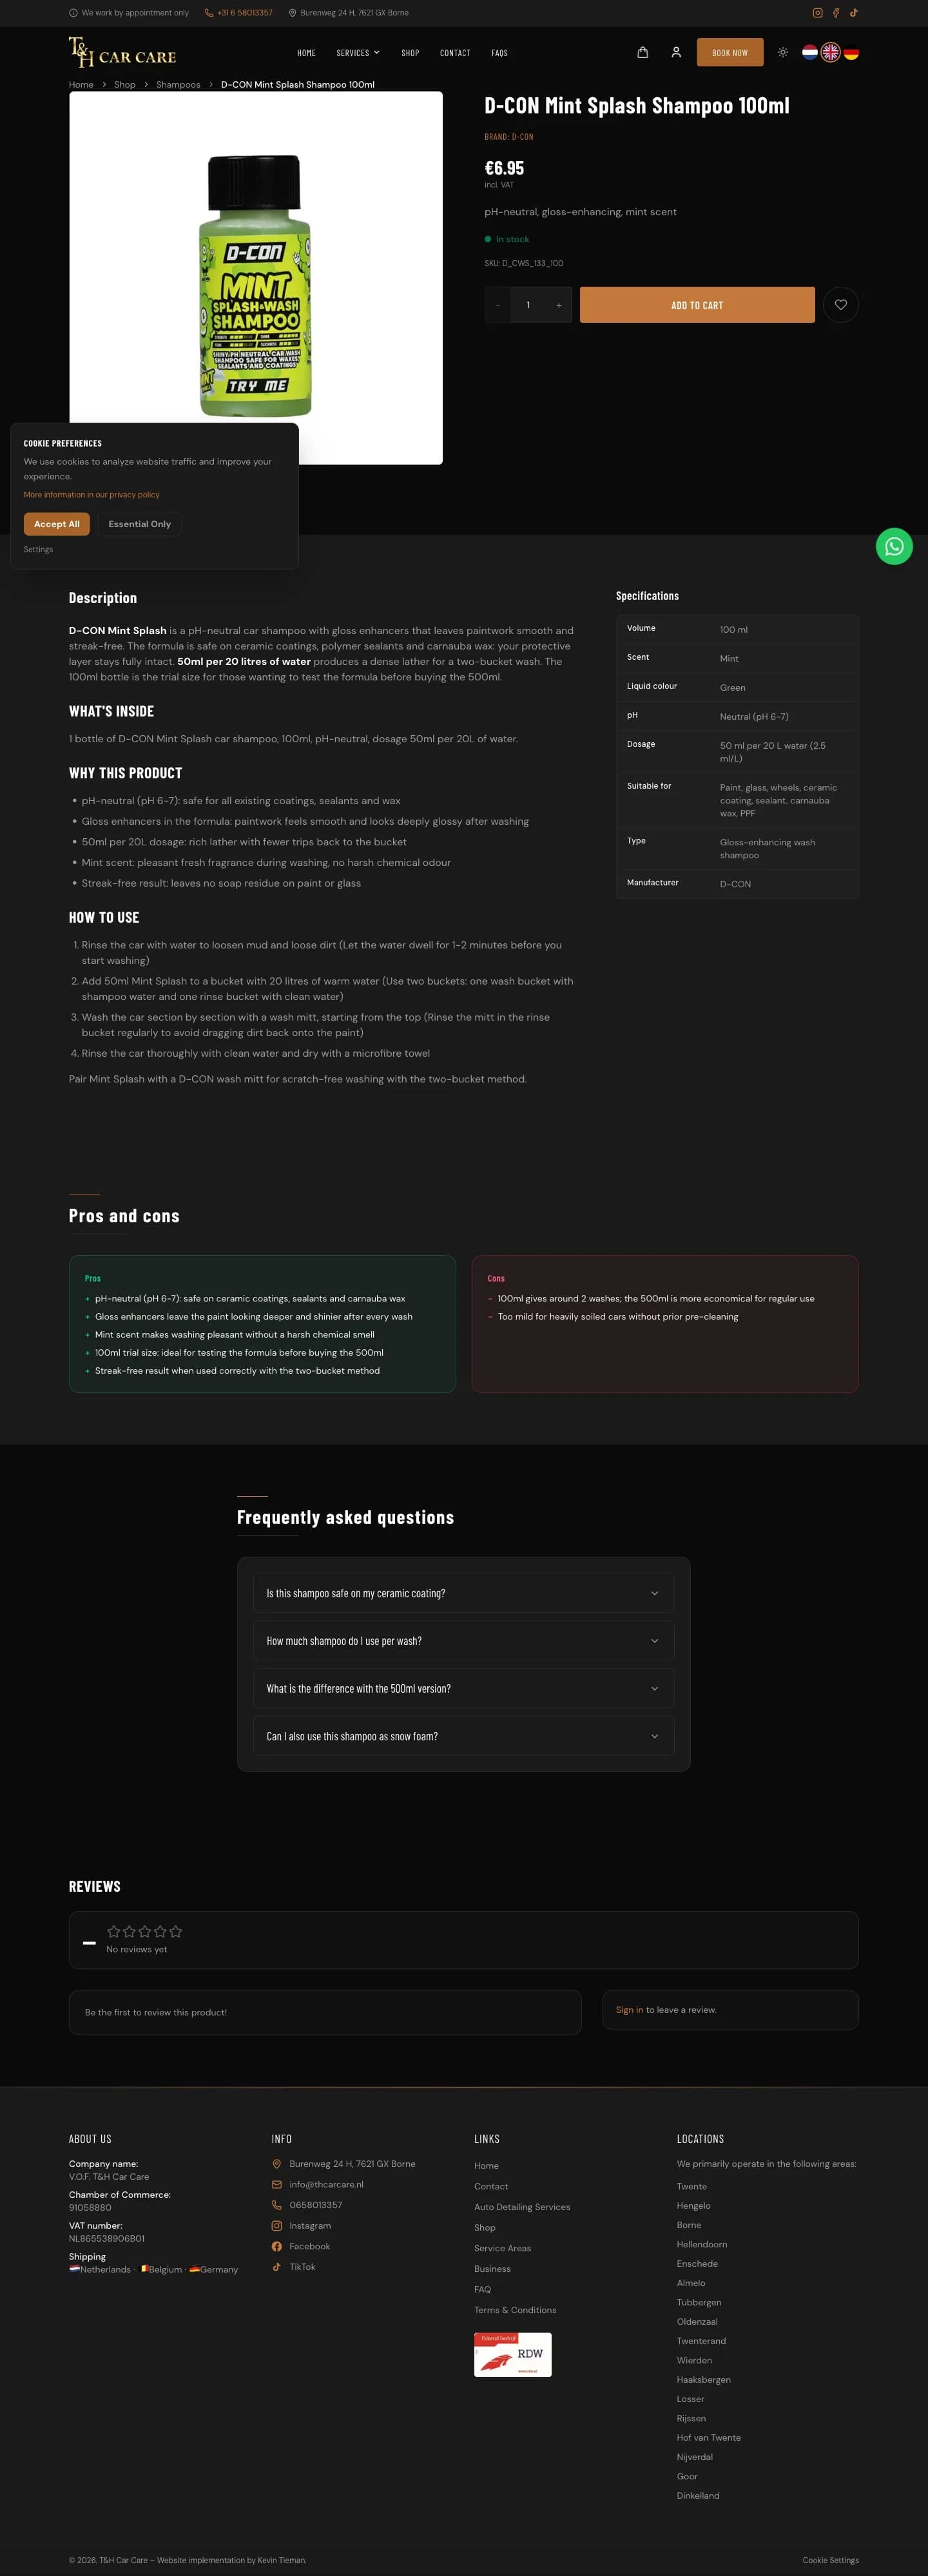
Identieke structuur, identieke feiten, andere taal. Dat is wat hreflang-parity betekent in de praktijk: je vertelt Google dat dit dezelfde productpagina is in een andere taal, en Google verifieert dat door de structuur en de identifiers naast elkaar te leggen.
Wat de pipeline niet doet
Geen marketingfluff. Geen "dompel uzelf onder in de premium ervaring". Geen vergelijking met dingen die je niet hebt verzonnen ("70% beter dan de concurrentie"). Geen fictieve reviews. Geen gegenereerde productfoto's die de werkelijke verpakking misvertegenwoordigen.
Wat ik wel kan doen, en wat we aan het verkennen zijn: upscale van bestaande productfoto's (getrouw, niet generatief), variaties van dezelfde foto in verschillende contexten (in een werkplaats, in de hand vastgehouden), en korte productvideo's via een externe partner zoals Highsfield. Maar dat is een aparte stap die ná de tekst komt, en pas zodra de eigenaar van de catalogus akkoord is met de IP-implicaties.
Wanneer dit werkt en wanneer niet
Dit werkt als:
- Je catalogus is groot genoeg dat handmatige copy onmogelijk is (>500 producten)
- De productdata is gestandaardiseerd (specs zijn extraheerbaar, EAN's zijn er)
- Je hebt een merknaam met een herkenbare stem die je in een prompt kunt vastleggen
- Je bent bereid om de output te controleren, niet blind te publiceren
Dit werkt niet als:
- Je verkoopt mode of meubels waar de "feeling" het belangrijkste verkoopargument is
- Je catalogus heeft 50 producten en handwerk levert betere output op
- Je hebt geen eigen merkstem en kopieert basically de leverancier-tekst (dan kun je beter die gewoon importeren)
- Je wilt fake reviews of geneste content (dat doe ik niet, en ik wil niemand die het wel doet als klant)
Wat het kost en wat het oplevert
In modeltokens komt dit uit op rond de twee tot vijf cent per product over de hele drie-staps-pipeline. Voor 2.000 producten zit je op pak 'm beet veertig tot honderd euro aan API-kosten. Daar bovenop komt mijn tijd om de pipeline-instructies te configureren per project (een paar dagen werk voor het eerste project, daarna sneller per opvolgproject omdat de structuur herbruikbaar is).
Het alternatief: een copywriter die 800 producten per maand aankan tegen, laag geschat, vijftien euro per pagina. Dat is dertigduizend euro voor één catalogus. En zonder de meertalige parity die deze pipeline garandeert.
De pipeline draait deels live op een eigen webshop in opbouw, thcarcare.nl. Daar zie je de output in productie en kun je zelf beoordelen of het leesbaar genoeg is om je portemonnee te trekken.
Rechtstreeks praten?
Heb je een catalogus van honderden of duizenden producten die je vroeg of laat moet herschrijven, en wil je weten of deze aanpak past bij wat jij verkoopt? Stuur me een bericht met je catalogus-omvang en een paar voorbeeld-producten. Ik geef je binnen één werkdag een eerlijke inschatting van of dit voor jou werkt of niet.
Klaar om te beginnen?
Neem contact op voor een vrijblijvend gesprek over de mogelijkheden.